


Содержание
Перейти к:
https://doi.org/10.17073/2500-0632-2026-01-1070
Перейти к:
Электропотребление горнопромышленных предприятий характеризуется выраженной нестационарностью из-за повторно-кратковременных режимов оборудования и резкопеременной нагрузки электросталеплавильного производства. Отклонение фактического потребления от плановых заявок на оптовом рынке электроэнергии и мощности (ОРЭМ) влечёт значительные штрафные санкции, что делает традиционные статистические методы недостаточно точными и требует адаптивных нейросетевых подходов. Разработана и обоснована нейросетевая модель краткосрочного прогнозирования электропотребления для минимизации штрафов ОРЭМ. Проведён сравнительный анализ шести архитектур (RNN, GRU, LSTM, BiLSTM, CNN-LSTM, с механизмом внимания) в двух стратегиях многошагового прогнозирования (прямая Direct и рекурсивная Recursive). Гиперпараметры подобраны методом Hyperband. Исследование выполнено на промышленных данных за 2022–2023 гг. (17 520 почасовых измерений) крупного горно-перерабатывающего предприятия. Результаты показали, что архитектура GRU с прямой стратегией обеспечивает наилучшую точность (MAPE 5,44 %) и максимальную экономию штрафных платежей – 21,25 % относительно сезонной наивной модели, что на тестовом периоде (IV квартал 2023 г.) составляет 38,6 млн руб. квартального эффекта. Выявлен эффект избыточной сложности: простые рекуррентные сети превосходят модели с механизмами внимания на данных ограниченного объёма. Рекурсивная стратегия уступает прямой из-за кумулятивного накопления ошибки и невозможности использования стохастических экзогенных PCA-факторов. Выводы подтверждают целесообразность перехода от экспертно-статистических методов к нейросетевым подходам для горнопромышленных предприятий с резкопеременными нагрузками.
Ематин Е.А., Карпенко С.М. Нейросетевые модели краткосрочного прогнозирования электропотребления горнопромышленного предприятия для оптового рынка электроэнергии. Горные науки и технологии. https://doi.org/10.17073/2500-0632-2026-01-1070
Ematin E.A., Karpenko S.M. Neural network models for short-term electricity consumption forecasting at a mining enterprise participating in the wholesale electricity market. Mining Science and Technology (Russia). https://doi.org/10.17073/2500-0632-2026-01-1070
Краткосрочное прогнозирование электропотребления промышленных предприятий является важной задачей для участия в оптовом рынке электроэнергии и мощности (ОРЭМ). Согласно действующим правилам рынка1 участники обязаны предоставлять почасовые заявки на планируемое потребление на сутки вперед. Отклонение фактического потребления от заявленного влечет штрафные санкции, масштаб которых определяется объемом небаланса и ценой электроэнергии в соответствующий час.
Электропотребление горноперерабатывающих предприятий характеризуется выраженной нестационарностью, обусловленной составом и режимами работы технологического оборудования. Электроприёмники таких предприятий разделяются на длительные режимы (нагревательные печи, насосы, вентиляторы, компрессоры) и повторно-кратковременные режимы (прокатное, электросталеплавильное, сварочное, подъёмно-транспортное оборудование), при этом большая часть электропотребления имеет циклический характер при круглосуточном непрерывном основном производстве. Особую роль в формировании резкопеременного характера нагрузки и нестационарности временных рядов играет электросталеплавильное производство: процесс электроплавки сопровождается нелинейностью сопротивления электрической дуги, что вызывает скачки потребления и провалы нагрузки на коротких интервалах [1]. Совместное действие повторно-кратковременных режимов и нелинейности дуги электросталеплавильных печей формирует ряды нагрузки. По характеру переключений эти ряды отличаются от профилей агрегированных энергосистем. Данные особенности затрудняют применение традиционных методов прогнозирования и обусловливают актуальность поиска адаптивных подходов.
Классические статистические методы прогнозирования временных рядов – авторегрессионные модели (ARIMA), модели с распределенными лагами (ADL), экспоненциальное сглаживание (Holt-Winters) – основаны на предположениях о стационарности и линейности процессов [2]. Для агрегированных региональных энергосистем со сглаженными профилями нагрузки и высокой инерционностью данные методы обеспечивают высокую точность (MAPE 1,5–2,0 %). Однако на уровне отдельного промышленного предприятия, где преобладают резкие переключения режимов и событийная динамика, ошибка классических методов возрастает до 4–7 %, что неприемлемо для минимизации штрафных платежей ОРЭМ.
Методы глубокого обучения, в частности рекуррентные нейронные сети (RNN), способны аппроксимировать сложные нелинейные зависимости без явного задания физических уравнений. Архитектуры LSTM (Long Short-Term Memory) [3] и GRU (Gated Recurrent Unit) [4] решают проблему исчезающего градиента классических RNN [5]. Они эффективно моделируют долгосрочные зависимости во временных рядах. Исследования на данных региональных энергосистем показывают, что LSTM достигает MAPE 0,3–0,7 % на горизонте 1–7 дней, превосходя методы градиентного бустинга на длинных горизонтах [1].
Альтернативным направлением являются архитектуры на основе механизма внимания (Attention) [6], включая Temporal Fusion Transformer [7] и специализированные модификации (Informer [8], Autoformer [9]). Теоретически механизм внимания позволяет модели учитывать информацию из всей входной последовательности, присваивая различные веса элементам в зависимости от их релевантности. Однако практическое применение трансформеров ограничено высокими требованиями к объему обучающих данных: на выборках менее 3–5 лет часовых измерений наблюдается склонность к переобучению [10].
Существующие сравнительные исследования, как правило, выполнены на агрегированных данных энергосистем [11] и не учитывают специфику резкопеременных нагрузок ГПП [1].
В прогнозировании электропотребления крупных непрерывных горноперерабатывающих предприятий сохраняется ряд пробелов. Во-первых, сравнительные исследования архитектур, как правило, выполнены на агрегированных данных энергосистем и не учитывают стохастический характер композитных PCA-факторов, описывающих производственные переменные. Во-вторых, сопоставления стратегий многошагового прогнозирования в литературе ограничены преимущественно парой Direct vs Recursive [12, 13] и опираются на теоретическую базу [14, 15] и анализ экспозиционного смещения в рекурсивных RNN [16], тогда как стратегии MIMO (одна модель с многомерным выходом, соответствует Direct Multi-Output из подраздела 1.3) и DirRec (гибрид Direct и Recursive [17]) рассмотрены вне сочетания с экзогенными PCA-факторами. В-третьих, резкопеременные нагрузки металлургического класса с круглосуточным непрерывным режимом основного производства не охвачены систематическим сравнением: имеющиеся работы либо ограничены отдельными переделами (электросталеплавильные печи [13]), либо не доводят сравнение стратегий до операционных метрик ОРЭМ.
Вклад настоящей работы – адаптация набора рекуррентных архитектур к классу крупных непрерывных горноперерабатывающих предприятий и эмпирическое обоснование выбора стратегии многошагового прогноза при стохастических экзогенных PCA-факторах. Целевая область применения результатов – задачи планирования на ОРЭМ, а не сопоставление на агрегированных бенчмарках.
Целью настоящей работы является разработка и экспериментальное обоснование нейросетевой модели краткосрочного прогнозирования электропотребления горнопромышленного предприятия, обеспечивающей минимизацию штрафных санкций на ОРЭМ.
Для достижения поставленной цели в работе решены следующие задачи, последовательно раскрываемые в разделе 1 «Методы» (задачи 1–3) и разделе 2 «Результаты» (задача 4):
В разделе 1 описаны исходные данные, методология разработки модели и метрики оценки качества. Раздел 2 содержит результаты экспериментального сравнения архитектур. В разделе 3 обсуждаются полученные результаты и ограничения исследования.
1 Постановление Правительства РФ от 27.12.2010 № 1172 «О правилах оптового рынка электрической энергии и мощности» (с изменениями и дополнениями). URL: http://pravo.gov.ru/proxy/ips/?docbody=&nd=102144342
Исследование выполнено на данных крупного горнопромышленного предприятия (ГПП). Информационная база включает почасовые измерения электропотребления за период с января 2022 г. по декабрь 2023 г., что составляет 17 520 временных точек. Целевая переменная – агрегированный баланс электропотребления производственных цехов и собственной генерации электроэнергии, полученный из автоматизированной системы коммерческого учета электроэнергии (АСКУЭ) предприятия.
Объект исследования – крупное горноперерабатывающее предприятие металлургического профиля. Состав основных переделов включает (на уровне типов производств) коксохимический, агломерационный, доменный, электросталеплавильный, конвертерный сталеплавильный и листопрокатные переделы, а также установки собственной генерации электроэнергии, частично покрывающие потребление за счёт внутренних источников (теплоэлектроцентрали, утилизационные установки). Основное производство ведётся в круглосуточном непрерывном режиме, в связи с чем в почасовом профиле электропотребления отсутствует выраженная сезонная составляющая. По характеру нагрузки электропотребители разделяются на работающие в длительных режимах (нагревательные печи, насосы, вентиляторы, компрессоры) и в повторно-кратковременных режимах (прокатное, электросталеплавильное, сварочное, подъёмно-транспортное оборудование). Основным источником нестационарности результирующего ряда электропотребления служит электросталеплавильное производство: режим электроплавки сопровождается нелинейностью сопротивления электрической дуги и резкопеременной нагрузкой печей. Идентифицирующие параметры предприятия в настоящей работе не приводятся.
Состав входных признаков моделей прямой стратегии прогнозирования (Direct, см. подраздел 1.3) включает шесть каналов. Целевая переменная – историческое почасовое электропотребление предприятия. К экзогенным признакам отнесены композитный фактор простоев оборудования (первая главная компонента 4 индикаторов простоев, доля объяснённой дисперсии 86,35 %), композитный фактор внутренней генерации (четвёртая компонента 4 узлов собственной генерации, 15,05 % дисперсии, корреляция с целевой 0,34), температура наружного воздуха, композитный календарный фактор (пятая компонента 7 календарных признаков, 14,22 % дисперсии, корреляция с целевой −0,35) и бинарный индикатор государственного выходного дня. Рыночные показатели ОРЭМ и нагрузка отдельных переделов (включая электросталеплавильный цех) на этапе формирования признаков были признаны малоинформативными по абсолютной корреляции с целевой переменной и в финальный набор экзогенных признаков моделей не вошли.
Композитные PCA-факторы рассчитывались по единой процедуре. Исходные признаки каждой группы предварительно стандартизованы методом z-score с центрированием по среднему и нормировкой по стандартному отклонению. Декомпозиция выполнена методом главных компонент на основе сингулярного разложения матрицы признаков. Вращение факторов (Varimax, Promax и пр.) и отбеливание компонент не применялись. Итоговая компонента в каждой группе выбиралась по максимуму абсолютной корреляции с целевой переменной из числа вариантов с одной, двумя или автоматически подобранным числом компонент по уровню объяснённой дисперсии 95 %. В финальный набор экзогенных признаков модели вошли три PCA-фактора: Equipment Downtime – 4 индикатора простоев оборудования, выбрана компонента 1, доля объяснённой дисперсии 86,35 %; Generation Output – 4 узла внутренней генерации, выбрана компонента 4, доля 15,05 % (корреляция с целевой 0,34); Time – 7 календарных признаков, выбрана компонента 5, доля 14,22 % (корреляция с целевой −0,35). Выбор последних компонент в группах Generation Output и Time обусловлен правилом отбора по максимуму |corr| с целевой переменной, а не по доле дисперсии.
Обработка пропусков распределена по этапам подготовки данных в соответствии с природой источника. На этапе свода с журналом технологических простоев применяется протяжка дат предшествующим значением. Агрегаты простоев (суммарная длительность и число инцидентов) заполняются нулями, что отражает семантику отсутствия события. На этапе обработки метеорологического ряда выполняется ресемплирование на часовой шаг с временной интерполяцией пропусков. На этапе формирования признаков выбросы целевой переменной, выявленные по правилу превышения трёх стандартных отклонений, заменяются полусуммой ближайших валидных соседних значений или медианой ряда при их недоступности. При расчёте главных компонент в группе используются строки без пропусков с последующим выравниванием по часовой сетке. При оценке мультиколлинеарности через коэффициенты вздутия дисперсии применяется заполнение медианой признака. На входе модели применяется страховочная процедура последовательной протяжки оставшихся пропусков вперёд и назад по времени, обеспечивающая непрерывность итогового почасового ряда за период 2022-01-01 – 2023-12-31 (17 520 наблюдений).
Разбиение выборки выполнено по времени без перемешивания: общий часовой ряд за период 2022-01-01 – 2023-12-31 (17 520 наблюдений) разделён на обучающую часть (2022-01-01 – 2023-06-30, 13 104 наблюдения), валидационную часть (2023-07-01 – 2023-09-30, 2208 наблюдений) и тестовую часть (2023-10-01 – 2023-12-31, 2208 наблюдений) при долях около 74,8/12,6/12,6 %. С учётом контекстного окна 168 ч (семь суток истории) и горизонта прогноза 24 ч итоговое число обучающих, валидационных и тестовых окон для конфигураций с прямой стратегией составляет 12 913/2017/2017; для конфигураций с рекурсивной стратегией (одношаговое обучение, тестирование на 24 шагах) – 12 936/2040/2017.
В качестве базовой архитектуры выбраны управляемые рекуррентные блоки (Gated Recurrent Unit, GRU) [4]. Архитектура GRU – упрощённая версия LSTM [18], объединяющая вентили забывания и входа в единый вентиль обновления. Математическая модель GRU-ячейки описывается следующей системой уравнений:
zt = σ(Wz ∙ [ht – 1, xt] + bz),
rt = σ(Wr ∙ [ht – 1, xt] + br),
h̃t = tanh (Wh ∙ [rt ⊙ ht – 1, xt] + bh),
ht = (1 − zt) ⊙ ht – 1 + zt ⊙ h̃t,
где zt – вентиль обновления (update gate); rt – вентиль сброса (reset gate); ht – скрытое состояние; ⊙ – поэлементное умножение.
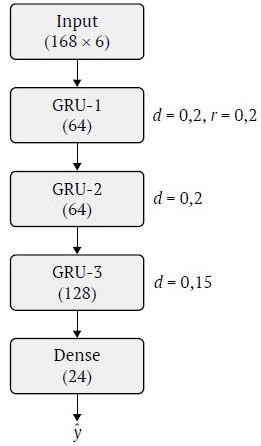
Рис. 1. Топология нейросетевой модели GRU (Direct). Числа в блоках – количество нейронов; d – коэффициент Dropout; r – Recurrent Dropout
Топология разработанной модели (рис. 1) включает следующие слои:
Размерность входа (Batch, 168, 6) соответствует контекстному окну 168 ч (одна неделя) и шести входным каналам, перечисленным в подразделе 1.1 (целевая переменная и пять экзогенных признаков). Конфигурации с рекурсивной стратегией (см. подраздел 1.3) используют отдельный univariate-вход формы (N, 168, 1) – только историю целевой переменной без экзогенных признаков.
Число обучаемых параметров модели (табл. 1) является соразмерным имеющемуся объёму данных и обеспечивает баланс между точностью аппроксимации и обобщающей способностью.
Таблица 1
Сводные результаты экспериментального сравнения моделей
Модель | MAPE, % | RMSE | Отношение дисперсий | Штраф, млн руб. | Экономия, % | Число обучаемых параметров* |
GRU (прямая) | 5,44 | 59,77 | 0,402 | 143,2 | 21,25 | 116 376 |
Attention-GRU | 6,12 | 73,56 | 0,237 | 149,8 | 17,58 | 47 328 |
RNN (прямая) | 6,42 | 76,42 | 0,201 | 158,4 | 12,88 | 53 272 |
LSTM (прямая) | 6,49 | 75,15 | 0,283 | 161,2 | 11,32 | 207 896 |
BiLSTM (прямая) | 6,60 | 76,49 | 0,238 | 165,5 | 8,94 | 83 736 |
RNN (рекурсивная) | 6,85 | 83,86 | 0,179 | 166,3 | 8,52 | 13 569 |
CNN-LSTM (прямая) | 6,68 | 76,74 | 0,192 | 166,3 | 8,52 | 86 136 |
Ridge AR | 6,78 | 82,19 | 0,249 | 167,0 | 8,14 | – |
BiLSTM (рекурсивная) | 6,88 | 84,35 | 0,184 | 167,9 | 7,65 | 75 457 |
LSTM (рекурсивная) | 6,94 | 85,31 | 0,183 | 168,8 | 7,14 | 111 841 |
GRU (рекурсивная) | 6,97 | 87,37 | 0,247 | 169,0 | 7,04 | 115 425 |
Ridge ADL | 6,82 | 80,13 | 0,292 | 169,4 | 6,81 | – |
CNN-LSTM (рекурсивная) | 7,23 | 87,59 | 0,186 | 176,2 | 3,05 | 82 689 |
S-Naive (сутки) | 7,35 | 96,52 | 0,750 | 181,8 | 0,00 | — |
LSTM-Attention (прямая) | 7,48 | 83,53 | 0,090 | 186,0 | −2,33 | 50 457 |
S-Naive (неделя) | 9,09 | 104,22 | 0,735 | 231,6 | −27,42 | – |
План предприятия | 14,32 | 144,26 | 0,082 | 399,2 | −119,60 | – |
*Для нейросетевых моделей приведено общее число обучаемых параметров сети. Для остальных конфигураций (регуляризованные авторегрессии Ridge AR и Ridge ADL, сезонные наивные модели S-Naive и действующий план предприятия) число обучаемых параметров не приведено: у Ridge-моделей – линейные коэффициенты, не сопоставимые по смыслу с весами нейросети; у наивных моделей и действующего плана – обучаемых параметров не имеется. В соответствующих ячейках проставлен прочерк.
Задача краткосрочного прогнозирования формулируется как построение отображения, которое на основании исторических данных за период L = 168 ч (контекстное окно, соответствующее одной неделе) формирует вектор прогноза на горизонт H = 24 ч вперед.
Для многошагового прогнозирования рассматривались две стратегии [19]: прямая (Direct Multi-Output, или MIMO [17]) и рекурсивная (Recursive [17, 20]). Далее «Direct», «прямая стратегия» и «прямой метод» используются как эквиваленты Direct Multi-Output, а «рекурсивная схема», «рекурсивная конфигурация» и «рекурсивный метод» – как эквиваленты Recursive. Прямая стратегия генерирует весь вектор прогнозов за один проход нейронной сети, используя выходной слой размерности 24. Рекурсивная стратегия формирует прогноз итеративно: каждое следующее значение вычисляется на основе предыдущего прогноза, который подаётся на вход модели вместо фактического значения. Особенностью предметной области, влияющей на выбор стратегии, является стохастический характер PCA-факторов (простои оборудования, режим собственной генерации): для рекурсивной схемы их значения на каждом будущем шаге прогноза недоступны как детерминированные величины и требовали бы отдельной модели экстраполяции экзогенных факторов.
В связи с этим конфигурации Direct и Recursive в настоящем сравнении различаются по структуре входа: прямая стратегия использует окно длиной 168 ч одновременно по целевой переменной и PCA-факторам и генерирует 24-часовой прогноз за один проход, тогда как рекурсивная конфигурация в табл. 1 реализована в univariate-режиме (вход – только окно прошлых значений целевой переменной, форма N × 168 × 1) с целью изолированной оценки накопления ошибки на горизонте 24 ч. Цифры по Recursive в табл. 1 предоставляют ориентир для случая, когда экзогенная информация на будущем горизонте недоступна, и используются при анализе вклада рекурсивной схемы в накопление ошибки (раздел 3).
Для выбора стратегии проведен сравнительный анализ на исторических данных (см. раздел 2).
Подбор гиперпараметров выполнен с использованием алгоритма Hyperband [21], реализующего адаптивное распределение вычислительных ресурсов между конкурирующими конфигурациями. Алгоритм основан на принципе последовательного сокращения (successive halving): конфигурации с низкой производительностью отсеиваются на ранних стадиях обучения, что позволяет сократить общее время поиска в 5–10 раз по сравнению со стандартным случайным поиском [22].
Пространство поиска гиперпараметров включало: архитектуру сети (RNN, LSTM, GRU, BiLSTM, CNN-LSTM, модели с механизмом внимания), количество рекуррентных слоев (1–3), размерность скрытых слоев (32–192 нейрона), коэффициент Dropout (0,1–0,3), скорость обучения (10−4–10−2, логарифмическая шкала), размер батча (32, 64, 128).
Обучение проводилось с использованием оптимизатора Adam со скоростью обучения 2 × 10⁻³ и динамическим снижением при выходе на плато (ReduceLROnPlateau). В качестве функции потерь использовалась среднеквадратичная ошибка (MSE). Применялась ранняя остановка при отсутствии улучшения метрики на валидационной выборке в течение 10 эпох. Итоговая модель достигла сходимости на 38-й эпохе из 50 максимальных.
Динамика обучения модели GRU представлена на рис. 2.
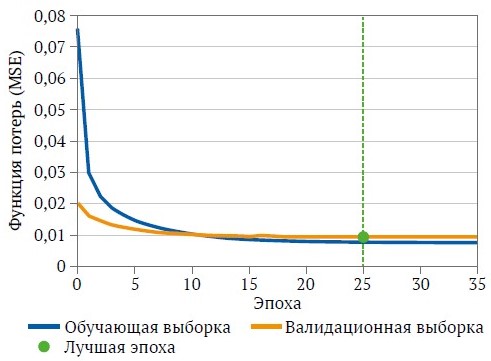
Рис. 2. Кривые обучения модели GRU (Direct): динамика MSE на обучающей и валидационной выборках. Лучшая эпоха – 25
Оценка качества моделей проводилась на тестовой выборке (IV квартал 2023 г., 85 сут, 2208 ч) в режиме ежедневного прогнозирования. Использовались следующие метрики:
Сезонная наивная модель (S-Naive Daily) используется как методический базис оценки экономии штрафных платежей: она фиксирует нижнюю планку точности нетривиальной модели [2, 19].
2 Постановление Правительства РФ от 27.12.2010 № 1172 «О правилах оптового рынка электрической энергии и мощности» (с изменениями и дополнениями). URL: http://pravo.gov.ru/proxy/ips/?docbody=&nd=102144342
В ходе исследования проведено сравнение 17 конфигураций, образующих полный факторный план: 12 нейросетевых конфигураций (шесть архитектур – RNN, GRU, LSTM, BiLSTM, CNN-LSTM [23, 24], модель с механизмом внимания – в двух стратегиях многошагового прогнозирования: прямой Direct Multi-Output и рекурсивной Recursive), две регуляризованные авторегрессии (Ridge AR, Ridge ADL), две сезонные наивные модели (S-Naive Daily, S-Naive Weekly) и действующий план предприятия как опорный ориентир. Результаты тестирования на выборке IV квартала 2023 г. представлены в табл. 1.
Экспериментальный план настоящего исследования организован как полный факторный набор из 17 конфигураций, что позволяет раздельно оценить вклад выбора архитектуры, стратегии многошагового прогнозирования и линейности отображения.
Результаты экспериментов однозначно демонстрируют лидерство модели GRU с прямой стратегией прогнозирования. Данная конфигурация обеспечила наилучшую точность (MAPE 5,44 %) и максимальный экономический эффект (экономия 21,25 %), значительно превосходя как наивные базисы, так и более сложные архитектуры с механизмами внимания.
Отношение дисперсий модели GRU с прямой стратегией составило 0,402, что свидетельствует о способности модели воспроизводить около 40 % естественной волатильности процесса электропотребления. Это выше, чем у моделей с рекурсивной стратегией (0,179–0,247), которые демонстрируют выраженный эффект сглаживания прогноза из-за накопления ошибки.
Архитектура GRU превзошла более сложную LSTM (MAPE 6,49 %) при меньшем количестве обучаемых параметров.
Способность модели адаптироваться к резким изменениям нагрузки проиллюстрирована на рис. 3 на примере провала нагрузки 30.10–01.11.2023. На горизонте 48 ч прогноза MAPE модели GRU (Direct) составила 17,22 %, тогда как линейная многофакторная модель Ridge ADL (168,6) с тем же шестиканальным входом – 43,70 %. Доверительные интервалы (95 %), показанные на рисунке, рассчитаны как ±1,96·σ̂ от эмпирического стандартного отклонения ошибки по каждому часу горизонта на тестовой выборке.

Рис. 3. Сравнение прогнозов моделей GRU (Direct) и Ridge ADL (168,6) при резком снижении нагрузки (30.10–01.11.2023). На основном графике показаны фактическое потребление, точечные прогнозы обеих моделей и 95 %-ные доверительные интервалы по эмпирической оценке ошибки на тестовой выборке; в области каждого дня прогноза вынесены значения MAPE по соответствующему 24-часовому участку. Нижняя панель – почасовая абсолютная процентная ошибка APE с горизонтальными линиями средних MAPE на горизонте 48 ч: GRU (Direct) 17,22 % / Ridge ADL(168,6) 43,70 %
Чтобы оценить вклад нелинейных зависимостей в точность прогноза, проведено сравнение с регуляризованными статистическими моделями. Ridge AR (168) – одномерная модель глубиной 168 ч – показала MAPE 6,78 %, Ridge ADL(168,6) с шестиканальным входом – MAPE 6,82 %. Ridge AR (168) использован как одномерный линейный якорь, отделяющий вклад нелинейности от вклада экзогенных факторов. Ridge ADL (168,6) показан на рис. 3 (см. раздел 2.2) как линейная модель с тем же шестиканальным входом, что и GRU.
Преимущество нейросетевой модели GRU перед Ridge AR составляет 1,34 пп по MAPE и 14,3 % по экономии штрафных платежей. Данный разрыв количественно характеризует вклад нелинейных эффектов: согласно работе [11] учёт нелинейной сезонности и тренда нейросетевыми моделями повышает точность по сравнению с линейными аналогами, что и подтверждается рекуррентной архитектурой GRU.
Сравнение отношений дисперсий прогнозов различных моделей представлено на рис. 4.
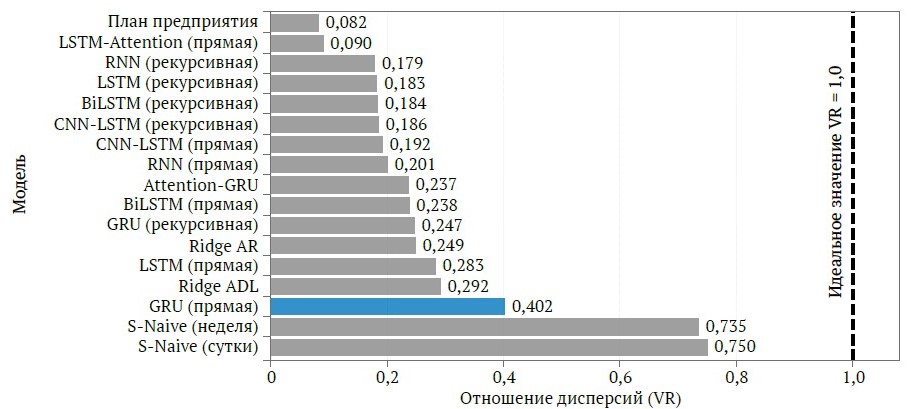
Рис. 4. Отношение дисперсий (VR) прогнозов моделей: VR = 1,0 соответствует полному сохранению дисперсии исходного ряда
Экономический эффект оценивался через снижение штрафных санкций на оптовом рынке электроэнергии и мощности (ОРЭМ). Штраф рассчитывается как произведение абсолютной ошибки прогноза на почасовую цену электроэнергии согласно действующим правилам рынка2.
При переходе от лучшего наивного ориентира – сезонной наивной модели (S-Naive) – к модели GRU с прямой стратегией снижение абсолютной ошибки составило 1,91 пп (с 7,35 до 5,44 %). На тестовом периоде (IV квартал 2023 г.) экономия штрафных платежей составила 38,6 млн руб., что эквивалентно снижению на 21,25 %. Аналогичный расчёт может быть выполнен на последующих периодах при сохранении режима эксплуатации.
2 Постановление Правительства РФ от 27.12.2010 № 1172 «О правилах оптового рынка электрической энергии и мощности» (с изменениями и дополнениями). URL: http://pravo.gov.ru/proxy/ips/?docbody=&nd=102144342
Одним из эмпирических наблюдений исследования является «парадокс сложности»: более простая архитектура GRU превзошла модели с механизмами внимания (Attention-GRU, LSTM-Attention), несмотря на теоретические преимущества последних. Данный результат согласуется с выводами критического обзора [10], показавшего, что на выборках малого и среднего объема (менее 3–5 лет почасовых данных) трансформерные модели склонны к переобучению.
На выборках малого и среднего объёма промышленного класса параметрическая ёмкость механизма внимания не насыщается обучающим сигналом, что повышает чувствительность к шуму и проявляется в подавлении волатильности прогноза вплоть до фактического воспроизведения сглаженного среднего профиля; результаты на промышленных данных ограниченного объёма согласуются с выводами обзора рекуррентных и трансформерных моделей [10] (см. табл. 1).
Архитектура GRU использует два управляющих вентиля (обновления и сброса) вместо трёх в LSTM (входной, забывания, выходной), что соответственно сокращает число обучаемых параметров на единицу скрытого состояния. На промышленных рядах с регулярными пропусками и выбросами это снижает склонность к переобучению и повышает устойчивость к выбросам и пропускам данных, что и наблюдается в сводных результатах (см. табл. 1).
Сравнение стратегий выявило преимущество прямого метода (Direct) над рекурсивным (Recursive) по MAPE и отношению дисперсий для всех исследованных архитектур (численные расхождения приведены в табл. 1).
Причина деградации точности рекурсивной стратегии заключается в кумулятивном накоплении ошибки: прогнозное значение на шаге k содержит ошибку, которая передаётся на вход при прогнозировании шага k + 1. На горизонте 24 ч этот эффект приводит к систематическому занижению волатильности прогноза, что отражается в значениях отношения дисперсий по конфигурациям с рекурсивной стратегией (см. табл. 1).
Дополнительным ограничением рекурсивной стратегии в контексте настоящей задачи является невозможность использования экзогенных PCA-факторов, отражающих стохастические технологические режимы. Прямая стратегия позволяет учитывать многофакторную природу электропотребления без необходимости прогнозирования самих факторов.
Действующий план предприятия формируется по принятой на предприятии процедуре подготовки плановых заявок на ОРЭМ. Его числовые показатели приведены в табл. 1 в качестве опорного ориентира; качественные оценки текущей системы планирования в настоящей работе не приводятся.
Следует отметить ограничения проведенного исследования. Во-первых, модель разработана и валидирована на данных одного предприятия, что требует дополнительной проверки переносимости результатов на другие объекты горнопромышленной отрасли. Объём обучающей выборки составляет около 13 000 почасовых наблюдений (см. раздел 1.1) и относится к единственному объекту, что ограничивает возможности обобщения и не позволяет в рамках настоящего исследования провести сопоставительный анализ между несколькими предприятиями. Во-вторых, модель формирует детерминированный точечный прогноз и не обеспечивает оценку неопределенности, что ограничивает возможности управления рисками на балансирующем рынке.
Перспективными направлениями развития являются расширение исследования на кластер предприятий с различными технологическими циклами, разработка вероятностной версии модели на основе архитектуры DeepAR [25] для генерации доверительных интервалов и интеграция модели в автоматизированную систему формирования заявок на ОРЭМ.
Сравнение шести рекуррентных и гибридных архитектур на данных горноперерабатывающего предприятия с непрерывным основным производством показало, что наилучшую точность прогноза электропотребления среди рассмотренных моделей даёт GRU. Архитектуры с механизмами внимания на выборках ограниченного объёма уступают простым рекуррентным моделям, наихудший результат – у LSTM-Attention с подавлением волатильности прогноза до сглаженного среднего профиля (см. табл. 1). Прямая стратегия многошагового прогнозирования обоснована как единственно применимая при использовании стохастических композитных PCA-факторов, не имеющих детерминированного будущего. Она сохраняет естественную волатильность процесса: отношение дисперсий модели GRU превышает соответствующее значение для действующего плана предприятия (см. табл. 1). Сравнение с регуляризованной авторегрессией Ridge AR подтверждает значимость нелинейных зависимостей в структуре данных. Гиперпараметры подобраны методом Hyperband, валидация выполнена на промышленных данных 2022–2023 гг. (~17 500 почасовых измерений). На тестовом периоде (IV квартал 2023 г.) разработанная модель даёт экономический эффект 38,6 млн руб. – снижение штрафных платежей на 21,25 % относительно базиса S-Naive Daily.
1. Klyuev R. V., Bosikov I. I., Gavrina O. A. et al. Improving the energy efficiency of technological equipment at mining enterprises. Advances in Intelligent Systems and Computing. 2021;1258:262–271. https://doi.org/10.1007/978-3-030-57450-5_24
2. Hyndman R. J., Koehler A. B. Another look at measures of forecast accuracy. International Journal of Forecasting. 2006;22(4):679–688. https://doi.org/10.1016/j.ijforecast.2006.03.001
3. Hochreiter S., Schmidhuber J. Long short-term memory. Neural Computation. 1997;9(8):1735–1780. https://doi.org/10.1162/neco.1997.9.8.1735
4. Cho K., van Merrienboer B., Gulcehre C. et al. Learning phrase representations using RNN encoder-decoder for statistical machine translation. In: Proceedings of the Conference on Empirical Methods in Natural Language Processing (EMNLP). Doha: ACL; 2014. Pp. 1724–1734. https://doi.org/10.3115/v1/D14-1179
5. Bengio Y., Simard P., Frasconi P. Learning long-term dependencies with gradient descent is difficult. IEEE Transactions on Neural Networks. 1994;5(2):157–166. https://doi.org/10.1109/72.279181
6. Vaswani A., Shazeer N., Parmar N. et al. Attention is all you need. In: Advances in Neural Information Processing Systems. 2017;30:5998–6008. https://doi.org/10.48550/arXiv.1706.03762
7. Lim B., Arik S. O., Loeff N., Pfister T. Temporal Fusion Transformers for interpretable multi-horizon time series forecasting. International Journal of Forecasting. 2021;37(4):1748–1764. https://doi.org/10.1016/j.ijforecast.2021.03.012
8. Zhou H., Zhang S., Peng J. et al. Informer: Beyond efficient transformer for long sequence time-series forecasting. In: Proceedings of the AAAI Conference on Artificial Intelligence. 2021;35(12):11106–11115. https://doi.org/10.1609/aaai.v35i12.17325
9. Wu H., Xu J., Wang J., Long M. Autoformer: Decomposition transformers with auto-correlation for long-term series forecasting. In: Advances in Neural Information Processing Systems. 2021;34:22419–22430. https://doi.org/10.48550/arXiv.2106.13008
10. Zeng A., Chen M., Zhang L., Xu Q. Are transformers effective for time series forecasting? In: Proceedings of the AAAI Conference on Artificial Intelligence. 2023;37(9):11121–11128. https://doi.org/10.1609/aaai.v37i9.26317
11. Zhang G. P., Qi M. Neural network forecasting for seasonal and trend time series. European Journal of Operational Research. 2005;160(2):501–514. https://doi.org/10.1016/j.ejor.2003.08.037
12. Ben Taieb S., Atiya A. F. A bias and variance analysis for multistep-ahead time series forecasting. IEEE Transactions on Neural Networks and Learning Systems. 2016;27(1):62–76. https://doi.org/10.1109/TNNLS.2015.2411629
13. Карпенко С. М., Карпенко Н. В., Безгинов Г. Ю. Прогнозирование электропотребления на горнопромышленных предприятиях с использованием статистических методов. Горная промышленность. 2022;(1):82–88. https://doi.org/10.30686/1609-9192-2022-1-82-88
14. Hewamalage H., Bergmeir C., Bandara K. Recurrent neural networks for time series forecasting: current status and future directions. International Journal of Forecasting. 2021;37(1):388–427. https://doi.org/10.1016/j.ijforecast.2020.06.008
15. Sangiorgio M., Dercole F. Robustness of LSTM neural networks for multi-step forecasting of chaotic time series. Chaos, Solitons & Fractals. 2020;139:110045. https://doi.org/10.1016/j.chaos.2020.110045
16. Zawodnik V., Schwaiger F., Sorger M., Kienberger T. Tackling uncertainty: forecasting the energy consumption and demand of an electric arc furnace with limited knowledge on process parameters. Energies. 2024;17(6):1326. https://doi.org/10.3390/en17061326
17. Ben Taieb S., Bontempi G., Atiya A. F., Sorjamaa A. A review and comparison of strategies for multi-step ahead time series forecasting based on the NN5 forecasting competition. Expert Systems with Applications. 2012;39(8):7067–7083. https://doi.org/10.1016/j.eswa.2012.01.039
18. Li H., Li S., Wu Y. et al. Short-term power load forecasting for integrated energy system based on a residual and attentive LSTM-TCN hybrid network. Frontiers in Energy Research. 2024;12:1384142. https://doi.org/10.3389/fenrg.2024.1384142
19. Bergstra J., Bengio Y. Random search for hyper-parameter optimization. Journal of Machine Learning Research. 2012;13(1):281–305. URL: https://www.jmlr.org/papers/v13/bergstra12a.html
20. Marcellino M., Stock J. H., Watson M. W. A comparison of direct and iterated multistep AR methods for forecasting macroeconomic time series. Journal of Econometrics. 2006;135(1–2):499–526. https://doi.org/10.1016/j.jeconom.2005.07.020
21. Li L., Jamieson K., DeSalvo G., Rostamizadeh A., Talwalkar A. Hyperband: A novel bandit-based approach to hyperparameter optimization. Journal of Machine Learning Research. 2018;18(185):1–52. https://doi.org/10.48550/arXiv.1603.06560
22. Chung J., Gulcehre C., Cho K., Bengio Y. Empirical evaluation of gated recurrent neural networks on sequence modeling. In: NIPS 2014 Workshop on Deep Learning. 2014. https://doi.org/10.48550/arXiv.1412.3555
23. Bai S., Kolter J. Z., Koltun V. An empirical evaluation of generic convolutional and recurrent networks for sequence modeling. arXiv preprint: 1803.01271. 2018. https://doi.org/10.48550/arXiv.1803.01271
24. Alhussein M., Aurangzeb K., Haider S. I. Hybrid CNN-LSTM model for short-term individual household load forecasting. IEEE Access. 2020;8:180544–180557. https://doi.org/10.1109/ACCESS.2020.3028281
25. Salinas D., Flunkert V., Gasthaus J., Januschowski T. DeepAR: Probabilistic forecasting with autoregressive recurrent networks. International Journal of Forecasting. 2020;36(3):1181–1191. https://doi.org/10.1016/j.ijforecast.2019.07.001
Евгений Александрович Ематин – аспирант кафедры энергетики и энергоэффективности горной промышленности
г. Москва
Scopus ID 59012304200
SPIN 2464-1230
Сергей Михайлович Карпенко – кандидат технических наук, доцент кафедры энергетики и энергоэффективности горной промышленности
г. Москва
Scopus ID 57225144783
SPIN 3950-0362
Ематин Е.А., Карпенко С.М. Нейросетевые модели краткосрочного прогнозирования электропотребления горнопромышленного предприятия для оптового рынка электроэнергии. Горные науки и технологии. https://doi.org/10.17073/2500-0632-2026-01-1070
Ematin E.A., Karpenko S.M. Neural network models for short-term electricity consumption forecasting at a mining enterprise participating in the wholesale electricity market. Mining Science and Technology (Russia). https://doi.org/10.17073/2500-0632-2026-01-1070



Главный редактор
Петров Вадим Леонидович Послать статью по эл. почте (Необходимо имя пользователя (логин))
Связаться с автором (Необходимо имя пользователя (логин))
119049, Российская Федерация, Москва, Ленинский проспект, д. 4, с. 1
ФГАОУВО «Национальный исследовательский
технологический университет «МИСИС» (НИТУ МИСИС)
Тел: +7 (968) 848-61-24, +7 (495) 955-00-77
E-mail: send@misis.ru





